




 0987.232.060
 0964.232.066
Data Mining là gì? Quy trình và các kỹ thuật khai phá dữ liệu
By lúc
Views: 1454 - Category: Kiến thức công nghệ, Tin tức - On:
Data Mining là quá trình khám phá và phân tích dữ liệu lớn để tìm ra các mẫu, xu hướng và mối quan hệ ẩn chứa trong đó. Quy trình Data Mining bao gồm nhiều bước, trong đó các kỹ thuật khai phá dữ liệu bao gồm phân loại, phân cụm, phân tích liên kết, và dự đoán giúp các doanh nghiệp đưa ra quyết định thông minh và tối ưu hóa hoạt động. Hãy cùng Hà Phương khám phá chi tiết về quy trình Data Mining nhé!

Giới thiệu tổng quan về Data Mining
Data Mining hay Khai phá dữ liệu là một quá trình phức tạp, bao gồm việc thu thập, làm sạch, tích hợp, biến đổi và phân tích các tập dữ liệu lớn, đa dạng. Qua việc áp dụng các thuật toán và mô hình thống kê. Quá trình này nhằm mục tiêu khám phá, nhận diện các mẫu ẩn, các mối tương quan phức tạp, cũng như các xu hướng tiềm ẩn trong dữ liệu. Từ đó, khai phá dữ liệu cung cấp những thông tin giá trị, hỗ trợ doanh nghiệp đưa ra các quyết định kinh doanh sáng suốt, tối ưu hóa hoạt động và nâng cao hiệu quả cạnh tranh.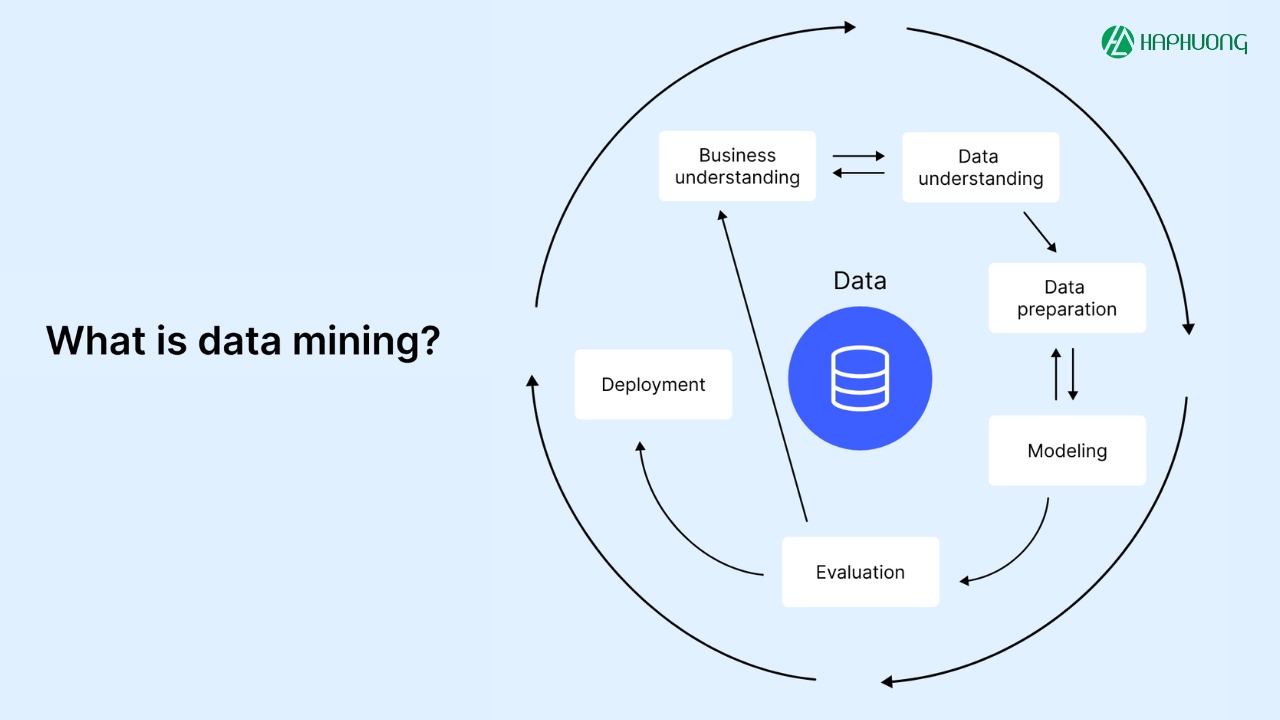
Tại sao Data Mining lại quan trọng?
Trong thời đại số, lượng dữ liệu được tạo ra mỗi ngày là vô cùng lớn. Dữ liệu chứa đựng tiềm năng to lớn để cải thiện hoạt động kinh doanh, nghiên cứu khoa học và nhiều lĩnh vực khác. Tuy nhiên, việc phân tích thủ công một lượng dữ liệu khổng lồ như vậy là bất khả thi. Data Mining ra đời để giải quyết vấn đề này giúp: Dự đoán xu hướng thị trường, hành vi khách hàng và các xu hướng khác nhằm hỗ trợ đưa ra các quyết định dựa trên dữ liệu, giảm thiểu rủi ro và tăng hiệu quả.
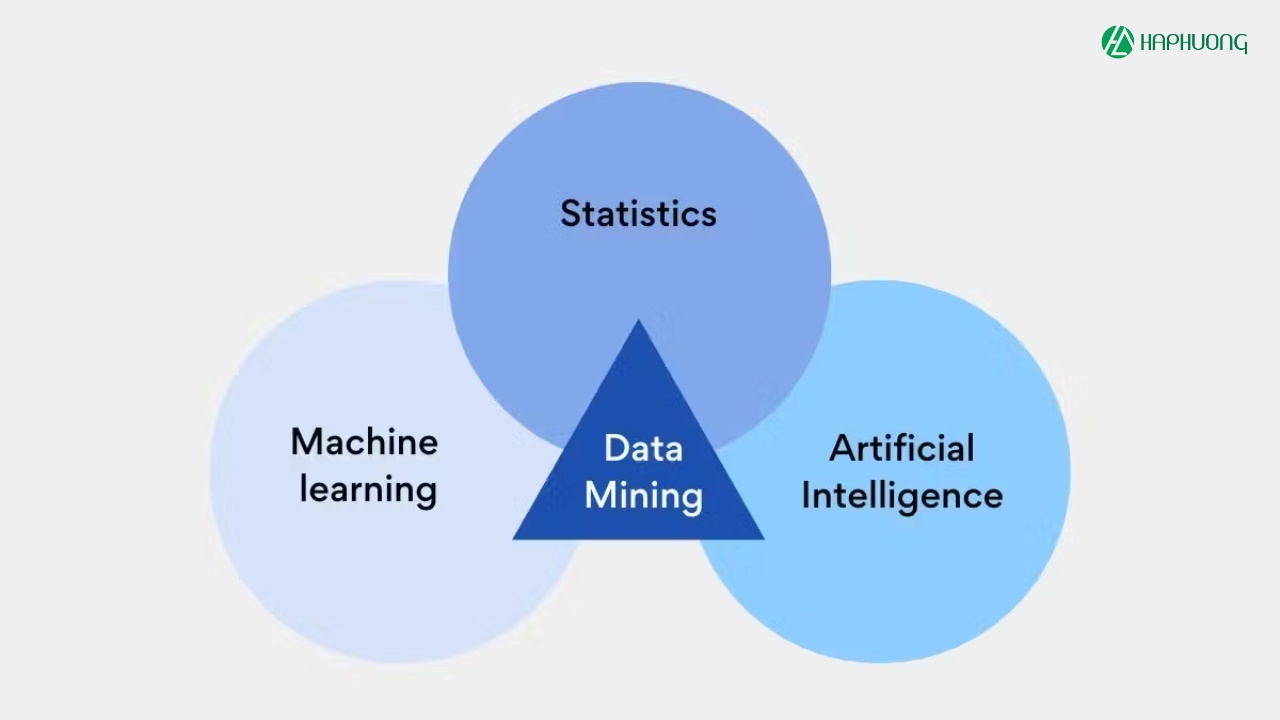
Data Mining còn giúp cá nhân hóa trải nghiệm, tạo ra các sản phẩm và dịch vụ phù hợp với từng cá nhân, nhận diện các hoạt động bất thường và gian lận nâng cao hiệu quả hoạt động, tối ưu hóa quy trình, giảm chi phí và tăng hiệu suất.
Quy trình Khai phá Dữ liệu (CRISP-DM)
CRISP-DM là một mô hình quy trình được sử dụng rộng rãi trong các dự án Khai phá Dữ liệu,cung cấp một khuôn khổ có cấu trúc để lập kế hoạch, thực hiện và quản lý các dự án khai thác dữ liệu một cách hiệu quả. CRISP-DM bao gồm 6 giai đoạn chính:
1. Business Understanding
Giai đoạn đầu tiên của Data Mining sẽ tập trung vào việc hiểu rõ mục tiêu và yêu cầu của dự án từ góc độ kinh doanh.:
- Xác định mục tiêu kinh doanh: Xác định rõ vấn đề kinh doanh cần giải quyết và mục tiêu cụ thể của dự án khai thác dữ liệu. Ví dụ: tăng doanh số bán hàng, giảm tỷ lệ khách hàng rời bỏ, tối ưu hóa chiến dịch marketing.
- Đánh giá tình hình: Đánh giá tình hình hiện tại, bao gồm các nguồn lực có sẵn, các ràng buộc và các yếu tố ảnh hưởng.
- Xác định mục tiêu khai thác dữ liệu: Chuyển đổi mục tiêu kinh doanh thành các mục tiêu cụ thể có thể đạt được thông qua khai thác dữ liệu như dự đoán khả năng khách hàng mua sản phẩm, phân khúc khách hàng thành các nhóm khác nhau.
- Lập Kế hoạch Dự án: Lập kế hoạch chi tiết cho dự án, bao gồm các giai đoạn, nhiệm vụ, nguồn lực và thời gian thực hiện.

2. Data Understanding
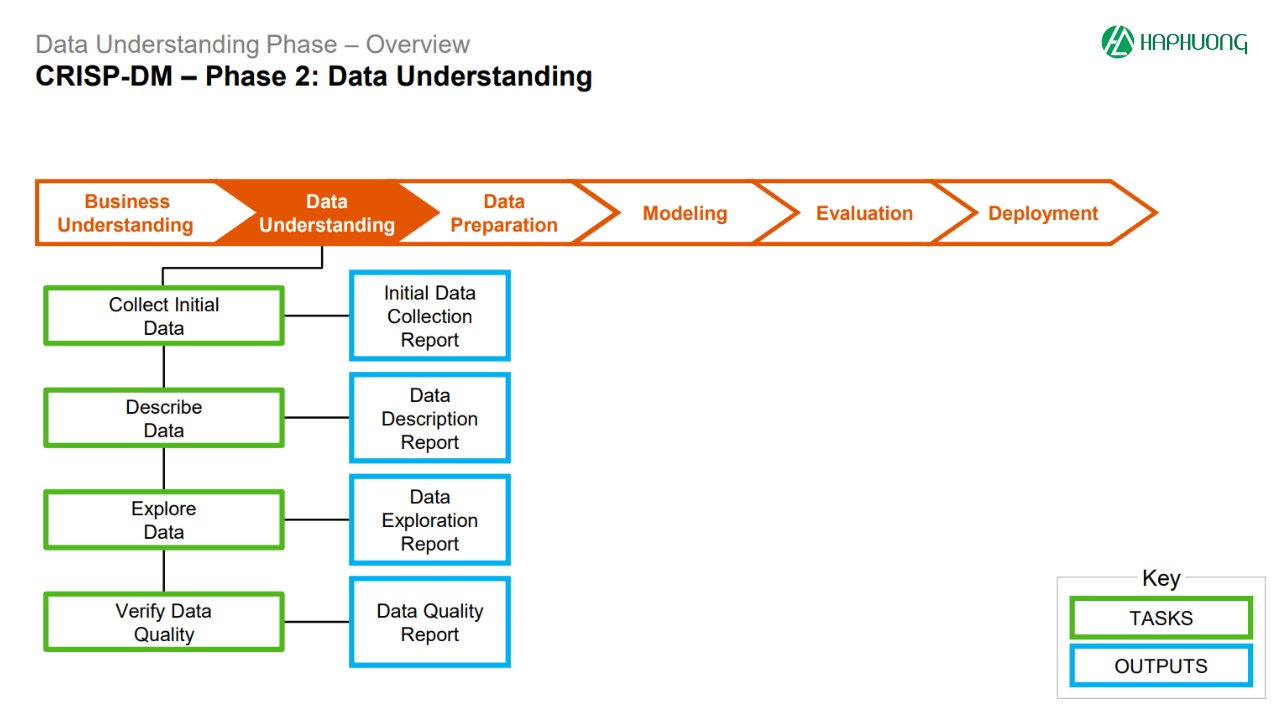
Giai đoạn hai tập trung vào việc thu thập, mô tả và khám phá dữ liệu để hiểu rõ về cấu trúc, nội dung và chất lượng, bao gồm:
- Thu thập Dữ liệu: Thu thập dữ liệu từ các nguồn khác nhau như cơ sở dữ liệu, tệp tin, nhật ký hệ thống.
- Mô tả Dữ liệu: Mô tả các đặc điểm của dữ liệu, bao gồm kích thước, định dạng, kiểu dữ liệu và các thuộc tính.
- Khám phá Dữ liệu: Khám phá dữ liệu bằng các kỹ thuật thống kê và trực quan hóa để hiểu rõ về phân bố, mối quan hệ và các đặc điểm quan trọng của dữ liệu.
- Đánh giá Chất lượng Dữ liệu: Đánh giá chất lượng của dữ liệu, tính đầy đủ, chính xác, nhất quán và tính hợp lệ.
3. Data Preparation
Data Preparation là giai đoạn tập trung vào việc làm sạch, chuyển đổi và tích hợp dữ liệu để chuẩn bị cho quá trình phân tích. Đây thường là giai đoạn tốn nhiều thời gian nhất trong quy trình CRISP-DM:
- Làm sạch Dữ liệu (Data Cleaning): Xử lý các giá trị thiếu, giá trị ngoại lệ và dữ liệu không nhất quán.
- Chuyển đổi Dữ liệu (Data Transformation): Chuyển đổi dữ liệu sang định dạng phù hợp cho việc phân tích, ví dụ như chuẩn hóa dữ liệu, mã hóa dữ liệu.
- Tích hợp Dữ liệu (Data Integration): Kết hợp dữ liệu từ các nguồn khác nhau thành một tập dữ liệu thống nhất.
- Giảm chiều Dữ liệu (Data Reduction): Giảm số lượng biến hoặc thuộc tính để giảm độ phức tạp của mô hình.
4. Modeling
Giai đoạn này tập trung vào việc lựa chọn và áp dụng các kỹ thuật khai phá dữ liệu phù hợp để xây dựng mô hình gồm:
- Lựa chọn Kỹ thuật Mô hình hóa: Lựa chọn các thuật toán và kỹ thuật phù hợp với mục tiêu khai thác dữ liệu và đặc điểm của dữ liệu.
- Xây dựng Mô hình: Xây dựng mô hình bằng cách áp dụng các thuật toán đã chọn lên dữ liệu đã được chuẩn bị.
- Hiệu chỉnh Mô hình: Điều chỉnh các tham số của mô hình để tối ưu hóa hiệu suất.
5. Evaluation
Giai đoạn Evaluation tập trung vào việc đánh giá hiệu suất của mô hình và đảm bảo đáp ứng được mục tiêu kinh doanh:
- Đánh giá Mô hình: Đánh giá hiệu suất của mô hình bằng các độ đo phù hợp như độ chính xác, độ thu hồi, F1-score.
- So sánh Mô hình: So sánh hiệu suất của các mô hình khác nhau để lựa chọn mô hình tốt nhất.
- Đánh giá theo Mục tiêu Kinh doanh: Đánh giá xem mô hình có đáp ứng được mục tiêu kinh doanh ban đầu hay không.
6. Deployment
Giai đoạn cuối cùng Deployment sẽ tập trung vào việc triển khai mô hình vào thực tế và giám sát hiệu suất, bao gồm:
- Triển khai Mô hình: Triển khai mô hình vào hệ thống thực tế để sử dụng.
- Giám sát Mô hình: Giám sát hiệu suất của mô hình theo thời gian và điều chỉnh nếu cần.
- Bảo trì Mô hình: Bảo trì và cập nhật mô hình để đảm bảo hiệu suất ổn định.
Các kỹ thuật khai phá dữ liệu phổ biến
Có rất nhiều kỹ thuật được sử dụng trong Data Mining, tùy thuộc vào loại dữ liệu và mục tiêu phân tích. Một số kỹ thuật phổ biến bao gồm:
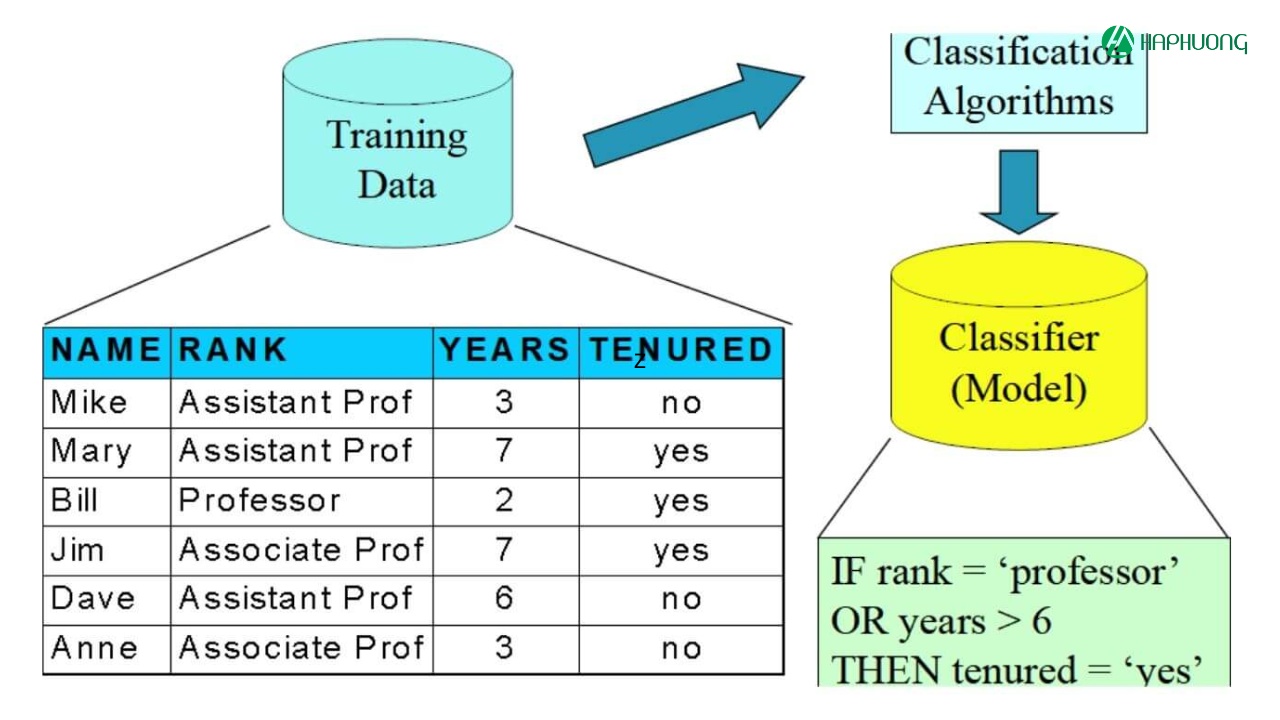
1. Classification
Classification hay Phân lớp là một quy trình phân loại các đối tượng dựa trên những đặc tính của chúng. Mục đích là để xác định nhóm mà mỗi đối tượng thuộc về, dựa trên các tập dữ liệu huấn luyện đã biết trước. Trong khai phá dữ liệu, phân lớp thường được sử dụng để dự đoán và dự báo nhóm cho dữ liệu mới.
Các kỹ thuật phổ biến:
- Cây quyết định (Decision Trees): Sử dụng các quy tắc phân nhánh để phân loại các đối tượng. Mỗi nhánh biểu thị một điều kiện dựa trên các đặc tính của dữ liệu.
- Máy vector hỗ trợ (SVM): Tìm một siêu phẳng tốt nhất để phân các nhóm trong không gian đa chiều.
- Thuật toán k lân cận (k-Nearest Neighbors): Xác định nhóm của điểm mới bằng cách xem xét các điểm gần nhất trong tập dữ liệu huấn luyện.
Ứng dụng:
- Phân loại email spam và email hợp lệ.
- Phân tích nguy cơ tín dụng trong tài chính.
- Dự báo bệnh lý trong lĩnh vực y tế, như phân loại nguy cơ bị ung thư.
2. Clustering
Clustering là kỹ thuật nhóm các đối tượng tương tự nhau vào các nhóm (hay còn gọi là các cụm). Khác với Classification, Clustering thường được sử dụng khi không biết trước nhóm hay danh mục. Mục tiêu của Clustering là tìm kiếm các nhóm tự nhiên trong dữ liệu giúp hiểu rõ cấu trúc dữ liệu đang phân tán và khám phá mối quan hệ tiềm ẩn giữa các đối tượng.
Các kỹ thuật phổ biến:
- K-Means: Thuật toán tìm k trung tâm và gán các đối tượng dữ liệu vào trung tâm gần nhất. Tiến trình này được lặp đi lặp lại cho đến khi không còn thay đổi đáng kể trong việc gán nhóm.
- Hierarchical Clustering: Xây dựng một cấu trúc phân cấp cho dữ liệu bằng cách hợp nhất hoặc chia nhỏ các cụm dựa trên độ tương đồng.
- DBSCAN (Density-Based Spatial Clustering of Applications with Noise): Phân cụm dựa trên mật độ, có khả năng phát hiện các cụm có hình dạng bất kỳ và loại bỏ nhiễu.
Ứng dụng:
- Phân đoạn khách hàng trong marketing.
- Phân tích hành vi người dùng trên website.
- Phát hiện gian lận tài chính dựa trên các mẫu giao dịch bất thường.

3. Association Rule Mining
Kỹ thuật này được sử dụng để khám phá các mối quan hệ hoặc quy tắc liên kết giữa các mục dữ liệu. Đây là phương pháp phổ biến trong việc phân tích giỏ hàng, nơi các sản phẩm thường được mua cùng nhau sẽ được xác định.
Các kỹ thuật phổ biến:
- Thuật toán Apriori: Tìm kiếm các tập hợp mục phổ biến bằng cách sử dụng một ngưỡng hỗ trợ tối thiểu, sau đó tạo ra các quy tắc liên kết.
- FP-Growth (Frequent Pattern Growth): Tạo cấu trúc cây để lưu trữ các tập hợp mục phổ biến, giảm thiểu việc quét dữ liệu nhiều lần.
Ứng dụng:
- Phân tích giỏ hàng trong bán lẻ để xác định các sản phẩm thường được mua cùng nhau.
- Gợi ý sản phẩm trên các nền tảng thương mại điện tử.
- Phân tích hành vi khách hàng để tối ưu hóa chiến lược kinh doanh.
4. Regression
Regression hay Hồi quy là một kỹ thuật phân tích và mô hình hóa mối quan hệ giữa một biến phụ thuộc và một hoặc nhiều biến độc lập. Mục tiêu là dự đoán giá trị của biến phụ thuộc dựa trên các biến đầu vào.
Các kỹ thuật phổ biến:
- Hồi quy tuyến tính (Linear Regression): Xác định mối quan hệ tuyến tính giữa các biến.
- Hồi quy logistic (Logistic Regression): Sử dụng để dự đoán các giá trị phân loại nhị phân.
- Hồi quy phi tuyến (Non-linear Regression): Mô hình hóa mối quan hệ phức tạp không tuyến tính.
Ứng dụng:
- Dự đoán giá cổ phiếu trong tài chính.
- Phân tích xu hướng doanh số bán hàng.
- Dự đoán chi phí y tế dựa trên các yếu tố sức khỏe.

5. Time Series Analysis
Time Series Analysis tập trung vào việc nghiên cứu dữ liệu được thu thập theo thứ tự thời gian. Mục tiêu là xác định các mẫu, xu hướng, hoặc sự thay đổi để dự đoán giá trị trong tương lai.
Các kỹ thuật phổ biến:
- ARIMA (AutoRegressive Integrated Moving Average): Mô hình sử dụng các thành phần tự hồi quy và trung bình trượt để dự đoán giá trị tương lai.
- LSTM (Long Short-Term Memory): Mạng nơ-ron chuyên biệt để xử lý và dự đoán chuỗi thời gian dài.
Ứng dụng:
- Dự báo thời tiết.
- Phân tích và dự đoán nhu cầu năng lượng.
- Dự báo doanh thu trong kinh doanh.
6. Anomaly Detection
Kỹ thuật này được sử dụng để xác định các điểm dữ liệu không tuân theo mẫu hoặc hành vi thông thường. Đây là một phương pháp quan trọng để phát hiện các sự kiện bất thường trong dữ liệu.
Các kỹ thuật phổ biến:
- Isolation Forest: Phát hiện bất thường bằng cách cô lập các điểm dữ liệu bất thường trong cây.
- One-Class SVM: Sử dụng để phân biệt giữa dữ liệu bình thường và dữ liệu bất thường.
- Gaussian Mixture Model: Ước lượng phân phối dữ liệu và xác định các điểm bất thường.
Ứng dụng:
- Phát hiện gian lận trong giao dịch thẻ tín dụng.
- Giám sát hệ thống máy móc công nghiệp.
- Phân tích an ninh mạng để xác định các cuộc tấn công.
7. Reinforcement Learning
Đây là một phương pháp học máy nơi tác nhân (agent) học cách tối ưu hóa hành vi của mình thông qua việc nhận phản hồi từ môi trường. Mục tiêu là tối đa hóa phần thưởng tổng thể qua thời gian.
Các kỹ thuật phổ biến:
- Q-Learning: Một thuật toán không cần mô hình, sử dụng bảng Q để lưu trữ giá trị hành động.
- Deep Q-Network (DQN): Kết hợp học sâu và Q-Learning để giải quyết các bài toán phức tạp hơn.
- Policy Gradient Methods: Tối ưu hóa trực tiếp chính sách hành động.
Ứng dụng:
- Điều khiển robot.
- Tối ưu hóa quảng cáo trực tuyến.
- Phát triển các chương trình chơi game tự động.
8. Text Mining
Phân tích văn bản là quá trình khai phá thông tin từ dữ liệu dạng văn bản phi cấu trúc. Mục tiêu là trích xuất các mẫu, xu hướng hoặc thông tin hữu ích từ văn bản.
Các kỹ thuật phổ biến:
- Xử lý ngôn ngữ tự nhiên (NLP): Phân tích ngữ nghĩa và cú pháp của văn bản.
- Phân tích cảm xúc (Sentiment Analysis): Xác định thái độ hoặc cảm xúc trong văn bản.
- LDA (Latent Dirichlet Allocation): Mô hình chủ đề để phân loại văn bản.
Ứng dụng:
- Phân tích ý kiến khách hàng từ đánh giá sản phẩm.
- Hệ thống gợi ý tự động trong các nền tảng thương mại điện tử.
- Trích xuất thông tin từ tài liệu pháp lý hoặc nghiên cứu khoa học.
Các công cụ khai phá dữ liệu
Có rất nhiều công cụ được sử dụng cho Data Mining, bao gồm cả mã nguồn mở và thương mại:
- R: Ngôn ngữ lập trình và môi trường phần mềm cho thống kê và phân tích dữ liệu.
- Python: Ngôn ngữ lập trình đa năng với nhiều thư viện mạnh mẽ cho Data Mining như scikit-learn, pandas, numpy.
- Weka: Bộ công cụ phần mềm mã nguồn mở cho Data Mining.
- RapidMiner: Nền tảng phân tích dữ liệu trực quan.
- KNIME: Nền tảng phân tích dữ liệu mã nguồn mở.

Những thách thức của Data Mining
Mặc dù mang lại nhiều lợi ích, Data Mining cũng đối mặt với một số thách thức:
- Chất lượng dữ liệu: Dữ liệu không đầy đủ, không chính xác hoặc không nhất quán có thể ảnh hưởng đến kết quả phân tích.
- Khả năng mở rộng: Xử lý và phân tích các tập dữ liệu cực lớn đòi hỏi khả năng tính toán mạnh mẽ.
- Bảo mật và quyền riêng tư: Việc thu thập và phân tích dữ liệu cá nhân cần tuân thủ các quy định về bảo mật và quyền riêng tư.
- Diễn giải kết quả: Việc diễn giải và hiểu được ý nghĩa của các kết quả phân tích đôi khi rất phức tạp.
Sản phẩm đề xuất


Tổng kết
Data Mining là một lĩnh vực mạnh mẽ với tiềm năng to lớn để biến dữ liệu thành kiến thức có giá trị. Với sự phát triển của công nghệ và lượng dữ liệu ngày càng tăng, Data Mining sẽ tiếp tục đóng vai trò quan trọng trong nhiều lĩnh vực trong tương lai. Hà Phương hi vọng bài viết trên đã cung cấp cho bạn một cái nhìn tổng quan và chuyên sâu về Data Mining. Nếu bạn có bất kỳ câu hỏi nào cần giải đáp, hãy liên hệ ngay với chúng tôi để được tư vấn và giải đáp trong thời gian sớm nhất.







